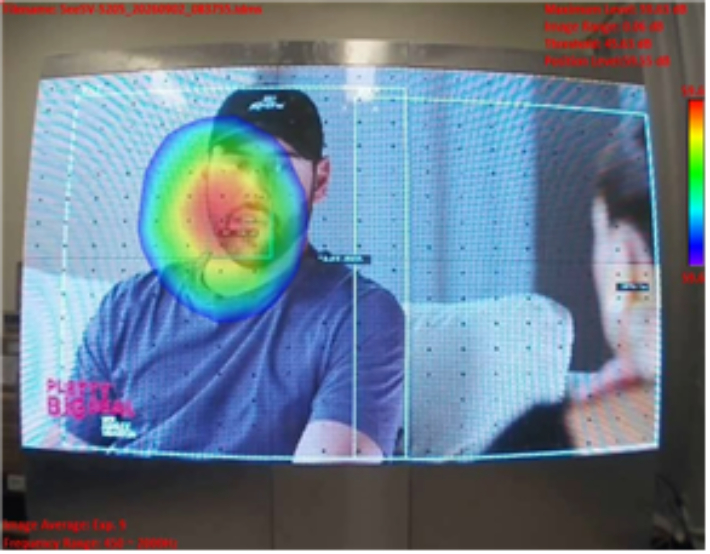
 디스플레이의 목표 구역에서 재생되는 소리를 음향카메라로 시각화한 모습. 기계연 제공
화면 속 인물이나 사물이 있는 바로 그 위치에서 소리가 들리는 시·청각 융합 디스플레이 핵심기술이 개발됐다.
한국기계연구원은 AX융합연구센터 김동준 선임연구원 연구팀이 디스플레이 뒷면에 부착한 다수의 진동 액추에이터를 정밀 제어해 원하는 화면 위치에서 소리를 방사하는 '모듈형 그리드' 기반 시·청각 융합 디스플레이 기술을 개발했다고 15일 밝혔다.
이번 기술은 패널 후면에 설치된 80개의 보이스코일모터(VCM)로 패널 표면의 진동 분포인 '진동장'을 제어한다. 패널의 진동 응답 특성을 분석한 뒤 역문제 기법으로 각 액추에이터에 입력할 전압 신호를 계산해 원하는 구역만 선택적으로 진동시키는 방식이다.
영상 속 음원의 움직임에 따라 소리 재생 구역을 실시간으로 변경해 소리가 화면 속 음원을 따라 이동하는 듯한 효과를 구현할 수 있다.
성능시험 결과, 목표 화면 구역에서 소리를 재생하는 선택 정확도 99.9%를 달성했다. 소리를 내도록 설정한 구역과 그렇지 않은 구역의 진동 크기 차이는 최대 35 dB를 기록해 특정 구역에 진동과 소리를 집중할 수 있음을 확인했다.
기존 대형 디스플레이는 스피커가 화면과 무관한 곳에 설치돼 영상의 방향과 소리가 들려오는 방향이 어긋나 몰입감을 저하하는 한계가 있었다. 기존 패널 진동형 스피커 역시 소리가 발생하는 위치와 패널 크기가 고정돼 음역과 화면 확장에 제약이 있었다.
연구팀은 '디스플레이의 스피커화'와 '디스플레이의 모듈화'를 결합한 모듈형 그리드 개념으로 이런 한계를 극복했다. 화면 자체에서 소리를 내면서 음원이 위치한 특정 구역만 선택적으로 진동시킬 수 있으며, 모듈을 결합하거나 분리해 가정용 TV부터 전시용 디스플레이, 디지털 사이니지, 대형 전광판까지 화면 크기에 맞춰 확장할 수 있다.
또 진동장 제어 과정에서 계산값이 불안정해지는 문제를 해결하기 위해 진동 전달 효과가 낮은 액추에이터를 연산에서 제외하는 '선별적 가진 알고리즘'을 개발했다. 연속된 음향 신호를 자연스럽게 연결하는 기법을 적용해 실시간 계산 과정에서 발생할 수 있는 음원 끊김과 잡음도 줄였다.
여기에 AI 기반 음원 분리 및 위치 추정 기술을 결합했다. AI가 영상 속 음원의 위치와 크기를 자동으로 파악하고, 여러 소리가 섞인 음원에서 원하는 소리를 분리해 해당 화면 구역에서 실시간으로 재생함으로써 영상과 소리의 위치를 자동으로 일치시킬 수 있다.
이번 기술은 화면 속 음원의 위치와 실제 소리 방향을 일치시켜 시각과 청각이 결합된 몰입형 콘텐츠를 구현할 수 있다. 향후 미디어아트, 공연·전시 콘텐츠, 디지털 사이니지, 대형 전광판, 차량용 디스플레이 등 다양한 분야에 활용이 가능하다고 연구팀은 설명했다.
김동준 선임연구원은 "앞으로 모듈형 LED 타일 디스플레이로 적용 범위를 확대하고, 다양한 디스플레이 분야에 활용할 수 있는 차세대 원천기술로 발전시켜 나가겠다"고 말했다.
영문기사 보기 (View English Article)